两张 2080Ti 跑 125B 大模型:不同上下文的 Prefill / Decode 实测
一句话结论:Prefill 速度单双卡没差别(主卡算力瓶颈);双卡的价值全在 Decode——把第二张卡的显存也填满专家权重,生成速度提升 30~40%(75 → 100 tok/s)。
测试环境
| 引擎 | Strata(MoE 专家分层卸载 + 投机解码) |
| 模型 | 125B MoE,IQ3_S 量化(3.5bit),int8 KV,最大上下文 224K |
| 显卡 | 2 × RTX 2080Ti(22G),PCIe 3.0 |
| 内存 | 192G DDR4(STREAM 实测 ~39GB/s) |
| 两种配置 | 单卡:专家缓存只填 GPU1;双卡:加 --expert-cache-device1 auto,GPU0 也填专家 |
实测数据
| 上下文 | Prefill 单卡 | Prefill 双卡 | Decode 单卡 | Decode 双卡 |
|---|---|---|---|---|
| 233 | 112 | 67 | 42.4 | 42.5 |
| 688 | 242 | 248 | 55.4 | 62.0 |
| 2,817 | 765 | 772 | 68.2 | 99.9 |
| 5,555 | 1,132 | 1,143 | 73.4 | 95.4 |
| 11,026 | 1,104 | 1,111 | 80.2 | 100.2 |
| 16,648 | 1,119 | 1,117 | 74.6 | 98.7 |
单位 tok/s。上下文为引擎实际处理的 prompt tokens(每档用随机盐前缀绕开前缀缓存,测的是"冷"速度)。超长上下文补充:118K prompt prefill 940-1,062 tok/s,decode 48-61 tok/s,不衰减。
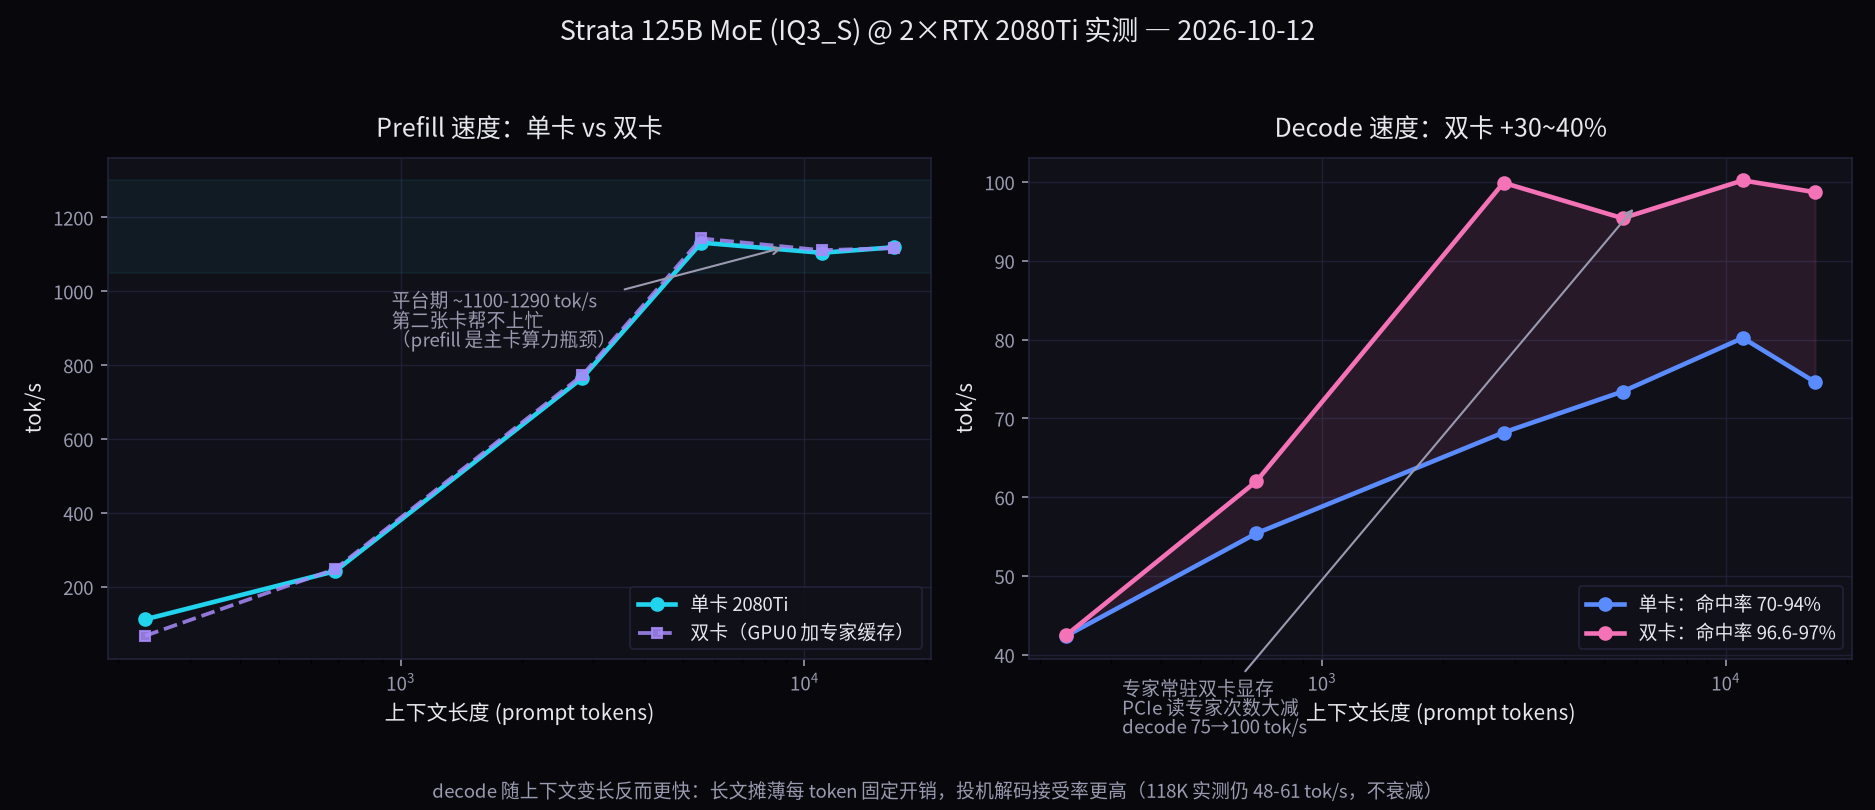
为什么 Prefill 单双卡没差别?
Prefill(读入 prompt)是算力密集的:每个 token 都要完整过一遍矩阵乘,全部发生在主卡上。第二张卡只帮忙"存"专家权重,不参与这部分计算,所以两条曲线几乎重合。
小 prompt 只有 100~250 tok/s,是因为每次请求的固定开销(调度、KV 分配、首 token 启动)摊不到几个 token 上;上下文 ≥3K 后摊薄充分,进入 ~1,100-1,290 tok/s 平台期——这就是 2080Ti 的 Turing Tensor Core 算力上限。
为什么双卡 Decode 快 30~40%?
Decode(逐 token 生成)是访存密集的:瓶颈不在算力,而在"每个 token 要把被路由到的专家权重搬进计算单元"。
单卡时专家缓存只装得下 ~6,500 个专家,命中率 70~94%,缺的专家要走 PCIe 从内存搬——PCIe 3.0 x16 只有约 16GB/s,成为瓶颈。双卡把 GPU0 的 22G 显存也填满专家(引擎日志实录:GPU1 侧 5,405 个专家条目),命中率升到 96.6~97%,绝大多数专家直接从本地显存读取,Decode 从 75 提到 ~100 tok/s。
一个反直觉现象:上下文越长,Decode 反而越快。
两个原因:① 长上下文下每 token 的固定开销占比趋近于零;② 连贯文本里投机解码(MTP draft)接受率更高——短请求约 85%,长文请求高达 99.7%(52,982 / 53,155),一次前向能确认多个 token。118K 超长上下文实测 Decode 仍有 48~61 tok/s,不衰减。
两个原因:① 长上下文下每 token 的固定开销占比趋近于零;② 连贯文本里投机解码(MTP draft)接受率更高——短请求约 85%,长文请求高达 99.7%(52,982 / 53,155),一次前向能确认多个 token。118K 超长上下文实测 Decode 仍有 48~61 tok/s,不衰减。
实用建议
- ✅ 日常对话 / 长文阅读:用单卡,省出 GPU0 给 ComfyUI 出图
- ✅ 追求生成速度且不出图:切双卡档,Decode 快 30~40%
- ⚠️ 双卡档会吃掉 GPU0 约 10G 显存,与 ComfyUI / 图生视频互斥,二选一
测法:流式请求逐 token 计时 + usage 计数,每档 6 点上下文梯度,随机盐前缀绕开前缀缓存。选型估算可参考 本地大模型选型器。