512K 上下文是怎么来的:YaRN 原理、本机实测与方法选型
1. 为什么模型"天生"读不了长文:RoPE 回顾
主流 LLM(包括本机 Strata 跑的 Qwen3.8-Flash-Next)用 RoPE(旋转位置编码)记词序:不给每个位置发"编号",而是把向量按位置旋转一个角度——位置每前进一格,转 θ 度。
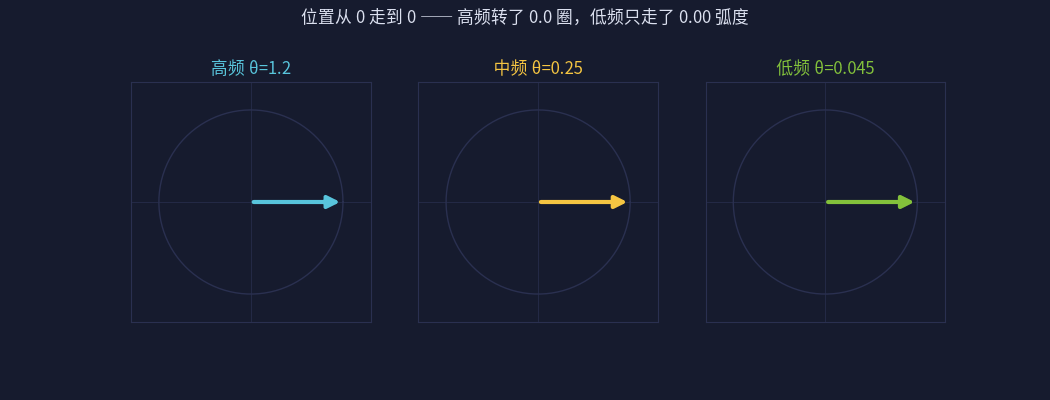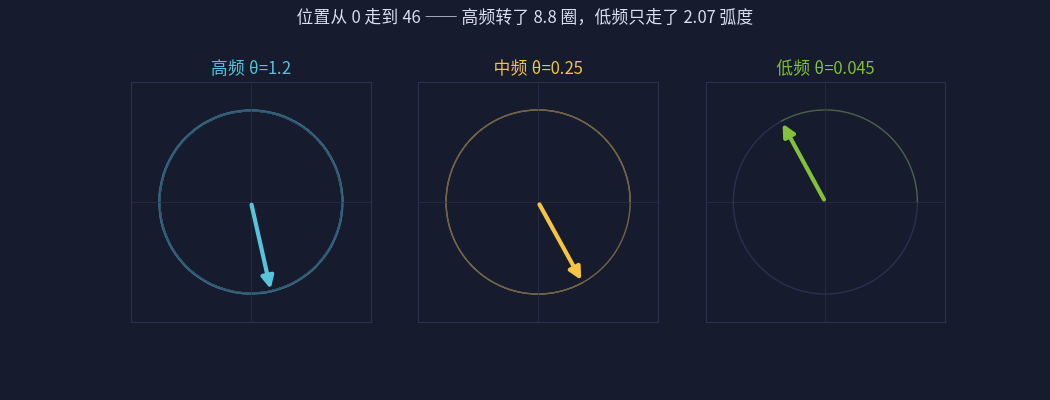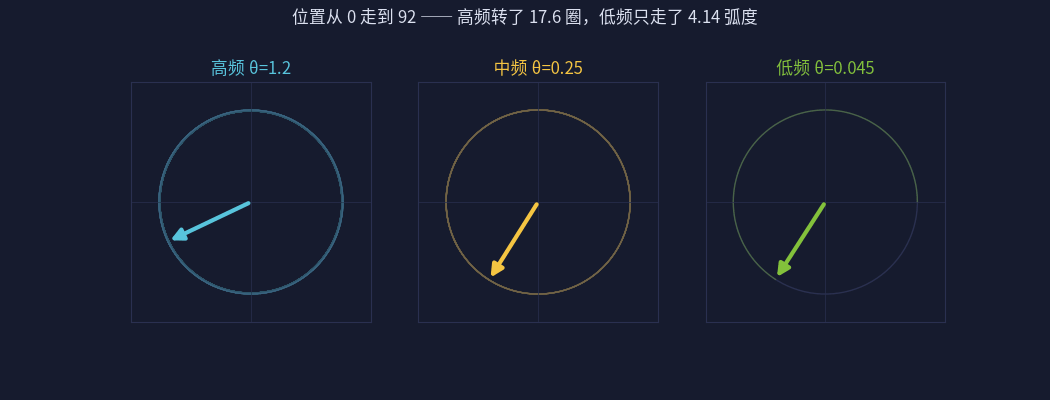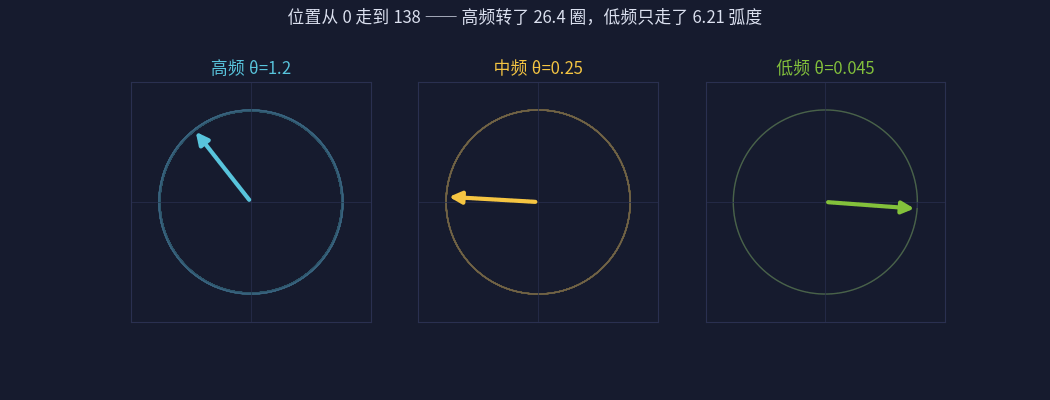
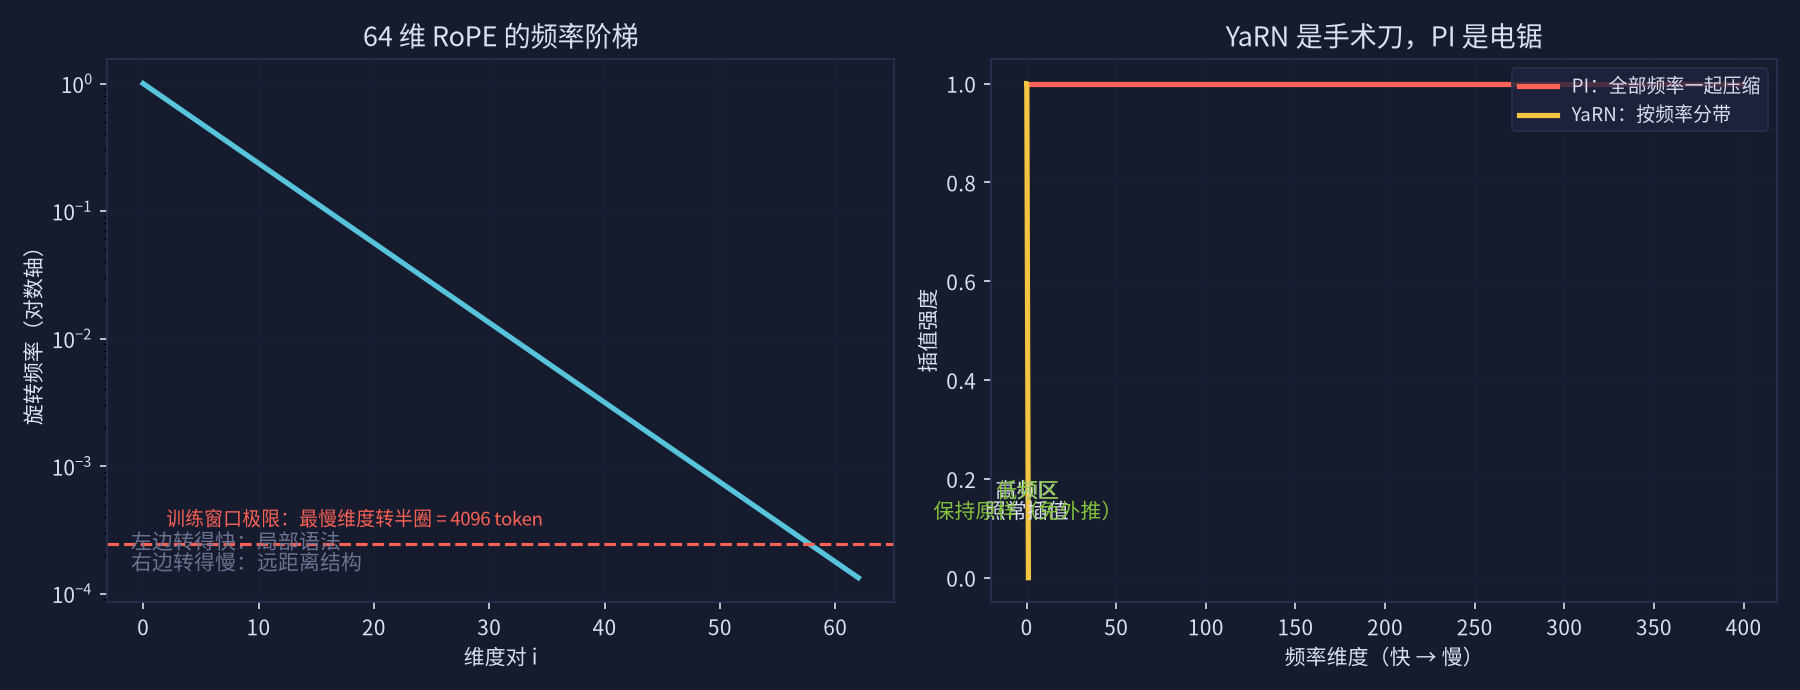
关键在"每个维度对转速不同":高频维度管局部语法(相邻词是谁),低频维度管远距离结构(开头和结尾什么关系)。最慢的维度在 4096 token 的训练窗口里连半圈都转不完。
问题就出在慢维度:硬塞 512K token,慢维度转了十几圈——模型从没见过这种角度组合,注意力直接错乱,这就是外推失败。
2. 最笨的解法与 YaRN 的聪明之处
PI(位置插值):把 512K 个位置整体压缩映射回模型熟悉的区间——128 公里硬画进 8 公里的地图。所有频率一起缩,副作用是高频维度本来分辨"相邻两个词",压缩后 16 个词挤成 1 格,局部细节糊了。
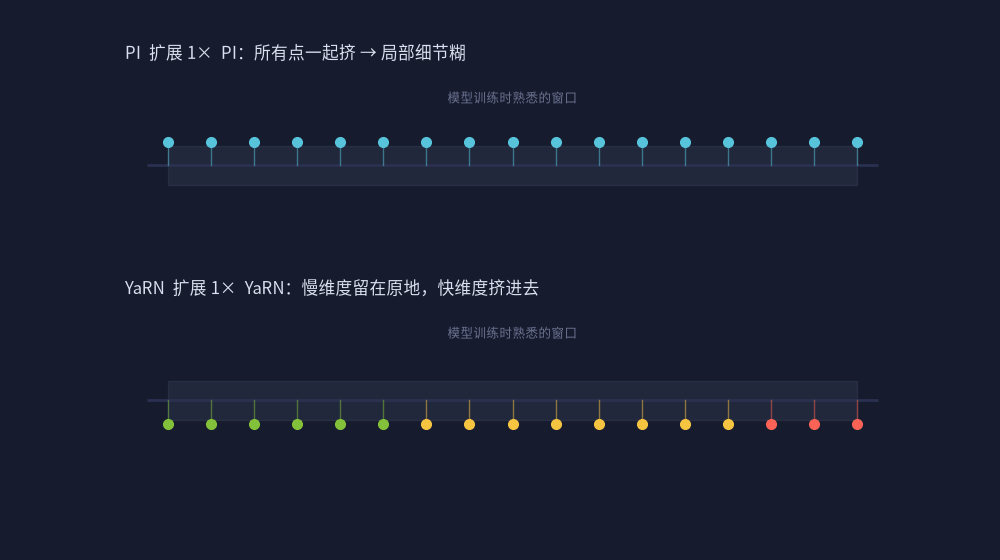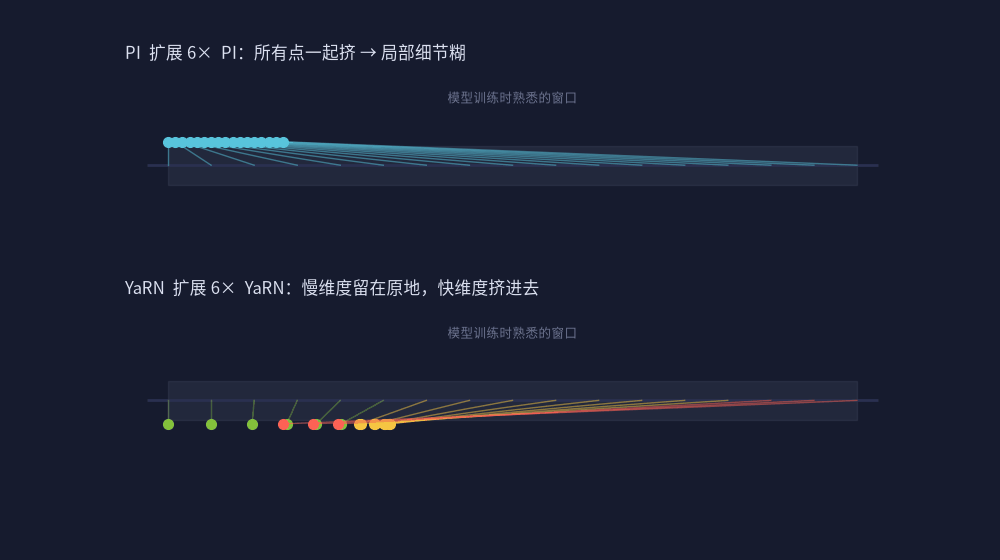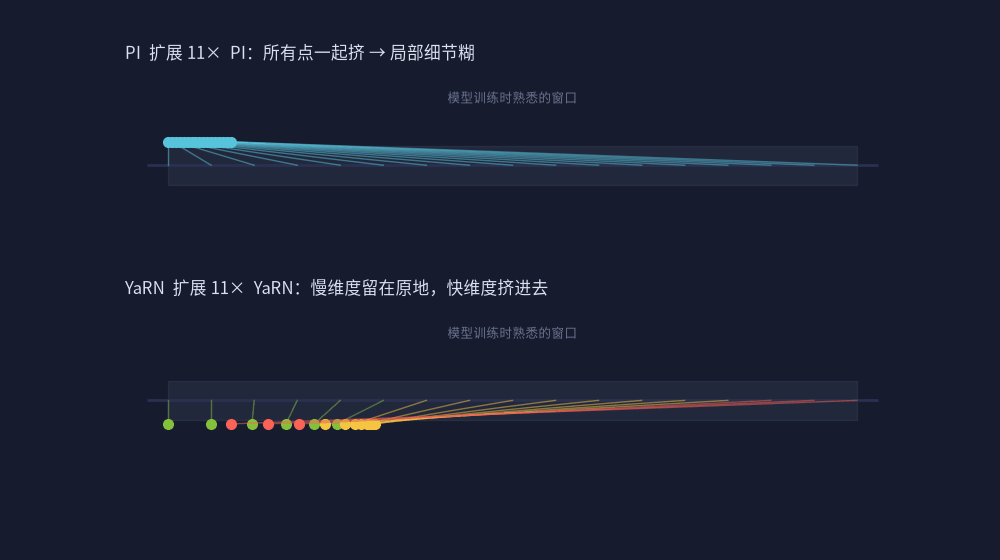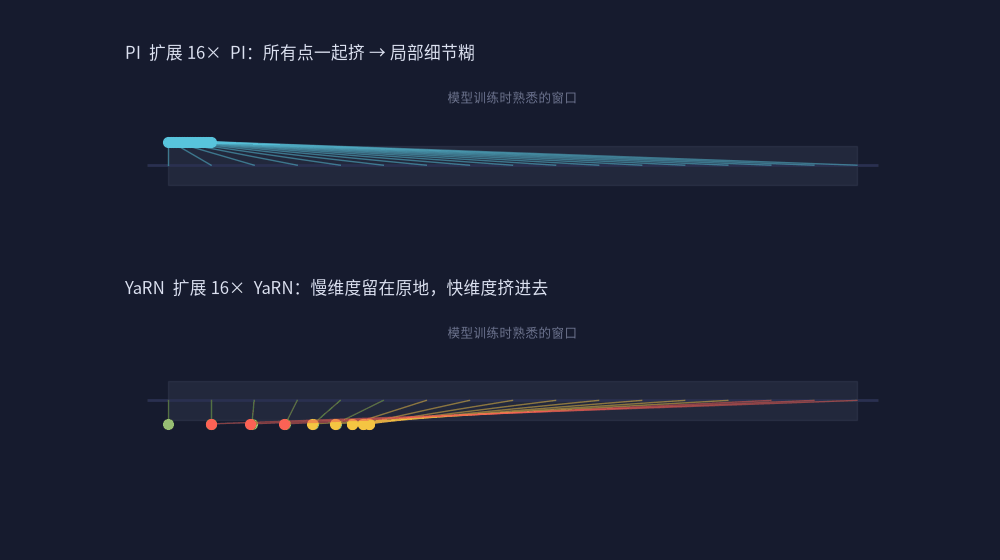
YaRN(Yet another RoPE extensioN)的核心洞察:不该一刀切——
- ① 高频维度(转得快、管局部)→ 照常插值压缩,它们对绝对距离不敏感
- ② 低频维度(转得慢、管远距)→ 不压缩保持原样,训练学到的"角度语义"继续有效
- ③ 中间用 ramp 斜坡平滑过渡;再给 softmax 加温度补偿 √s,防止注意力过度集中
3. Strata 里怎么用(实际例子)
配置文件里就两行参数(本机 512K 档实测配置):
"--max-context", "524288",
"--rope-scaling", "yarn",
"--rope-scale", "2",
--rope-scale 2 = 原生 262144(256K)× 2 = 524288(512K)。切换:
sudo ./switch.sh iq3s      # 224K 原生档(日常默认)
sudo ./switch.sh iq3s512k  # 512K YaRN 档(互斥,要重启引擎)
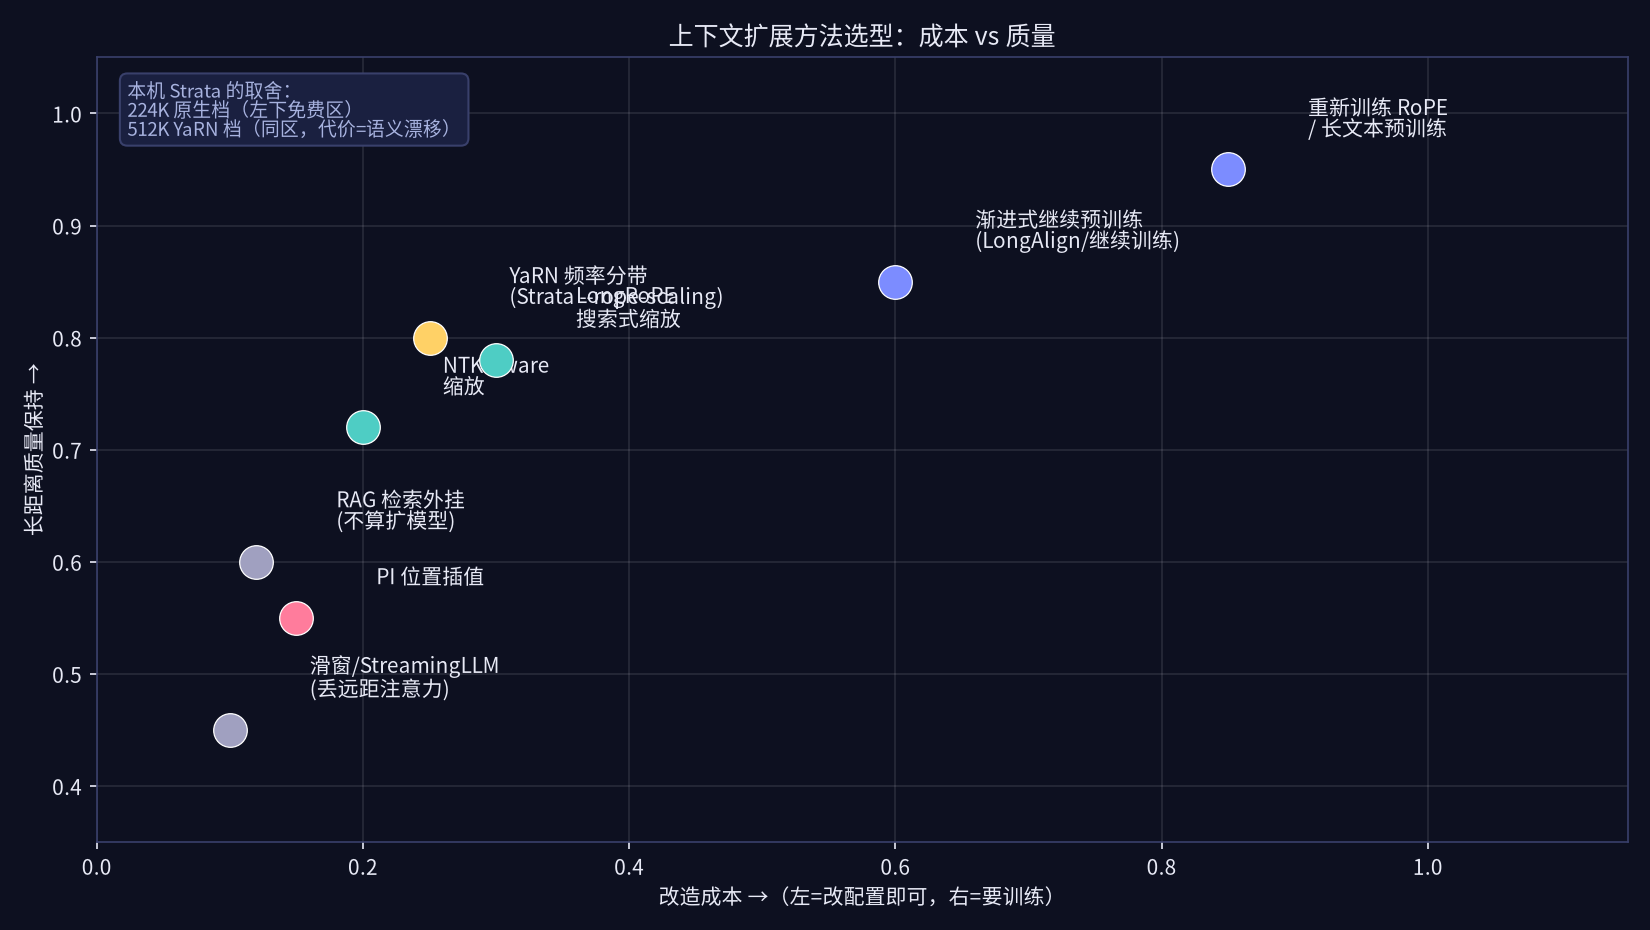
选择规则(本机验证):≤224K 永远用原生档(YaRN 有语义漂移税);只有确实要读 224K~512K 的整本书/大代码库才切 YaRN。
4. 实测:扩展上下文的真实代价
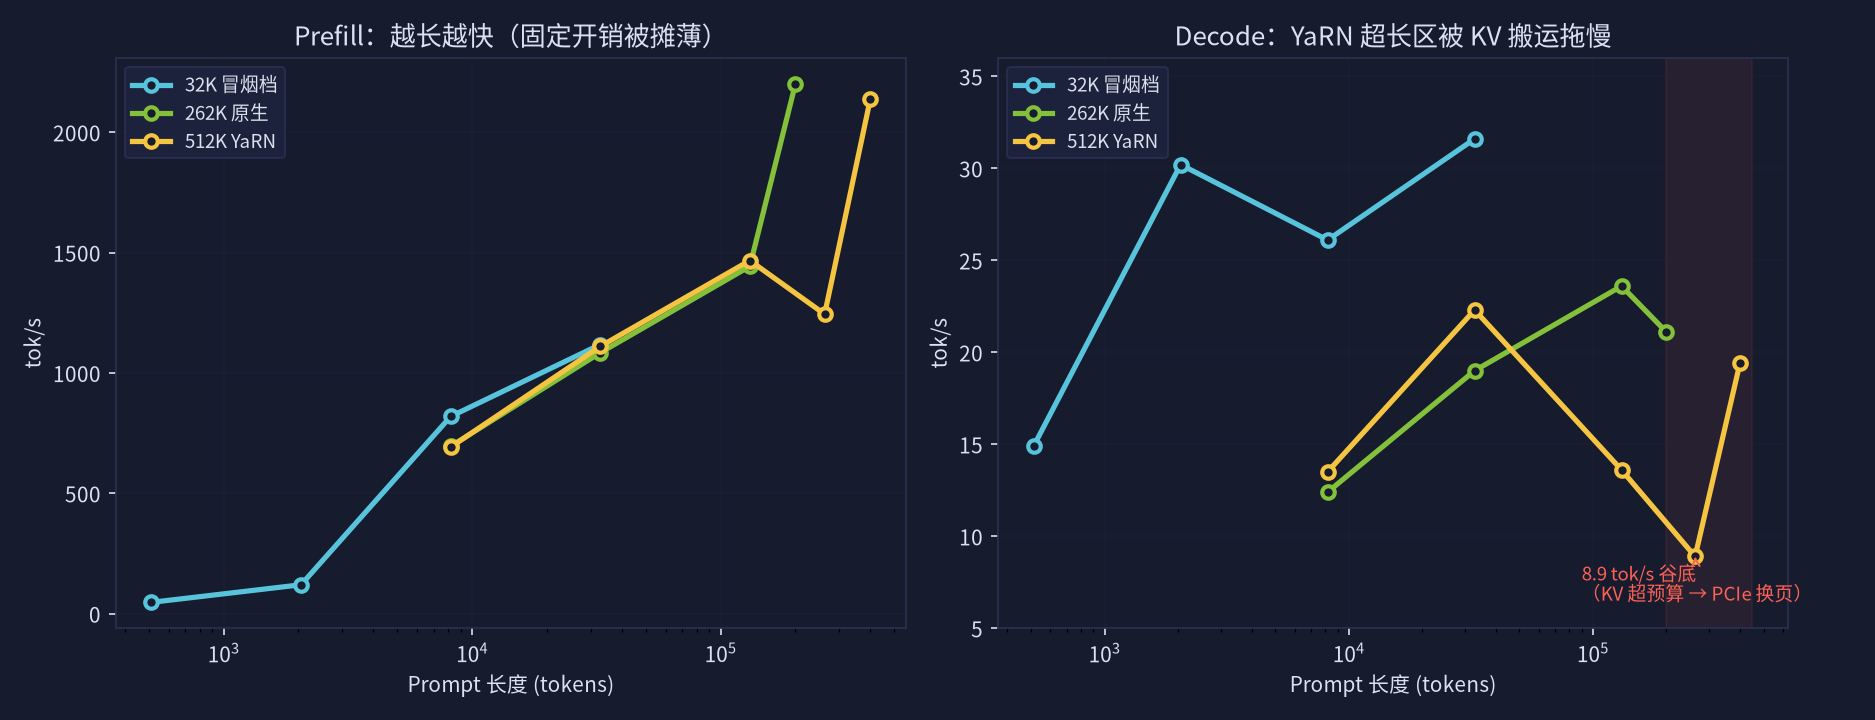
Swift 1.5-IQ4_XS 在 GPU0 上三档上下文完整基准(流式测 TTFT / decode):
| Prompt 长度 | Prefill tok/s | Decode tok/s |
|---|---|---|
| 512 | 47 | 14.9 |
| 2K | 120 | 30.2 |
| 8K | 692~819 | 12~26 |
| 32K | 1084~1118 | 19~32 |
| 128K | 1443~1467 | 13.6~23.6 |
| 262K(YaRN) | 1244 | 8.9 |
| 400K(YaRN) | 2136 | 19.4 |
三个反直觉现象:
- ① Prefill 越长反而越快——短 prompt 固定开销(加载/图重建)摊不掉,长 prompt 是流水线满速
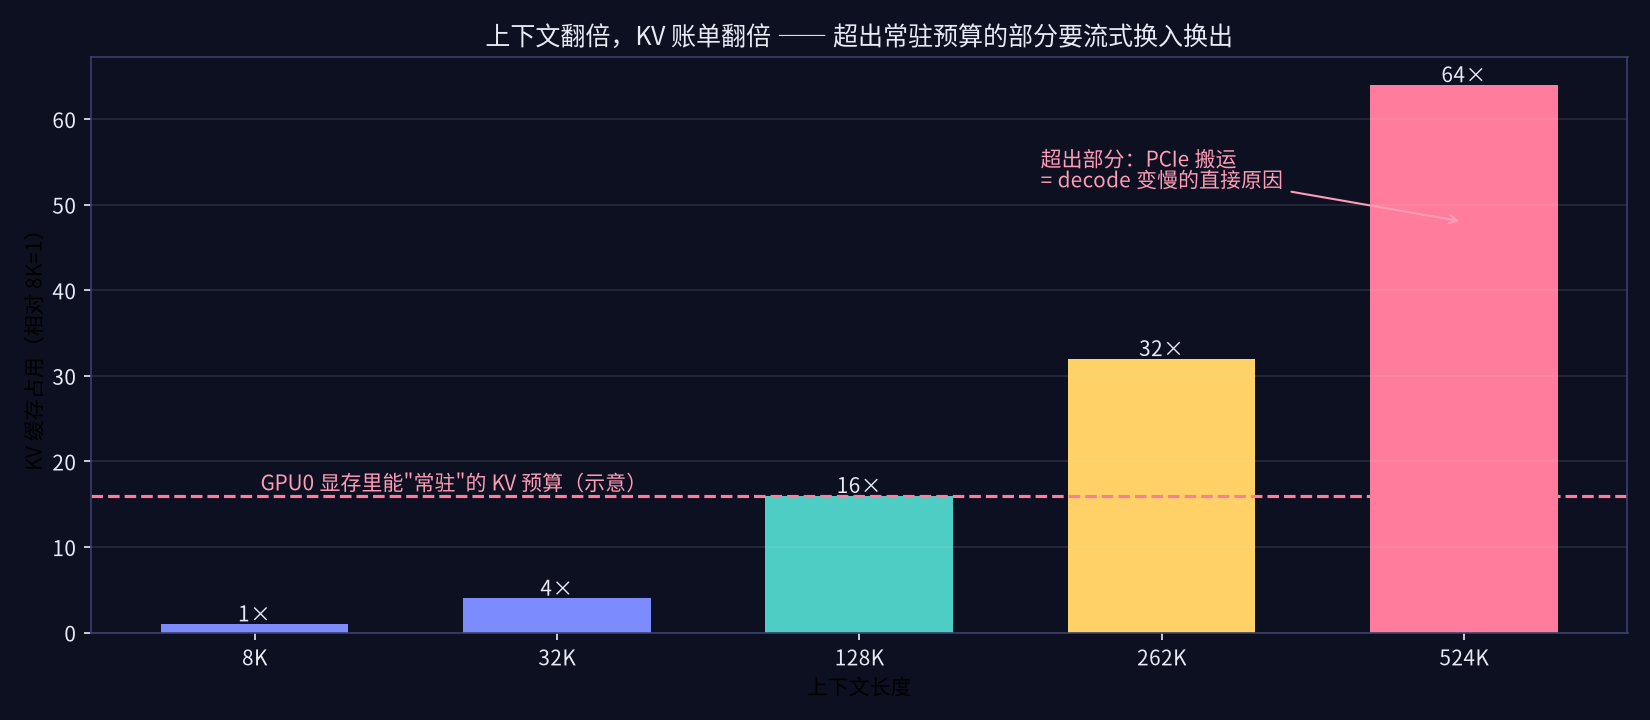
- ② Decode 在超长区掉速:262K 处 8.9 tok/s。元凶不是 YaRN 而是 KV 缓存账单:上下文翻倍 KV 翻倍,超出 GPU 常驻预算(
--kv-resident 20480)的部分走 PCIe 流式换入换出 - ③ 400K 回升到 19.4 是会话缓存+专家缓存 88.9% 命中的结果——长上下文速度高度依赖缓存状态
5. 上下文扩展方法全景(怎么选)
| 方法 | 原理 | 成本 | 适用 |
|---|---|---|---|
| PI 位置插值 | 全部频率压缩 | 改配置 | 应急,质量损失大 |
| YaRN | 频率分带+温度补偿 | 改配置 | 性价比之王,Strata/llama.cpp/vLLM 内置 |
| NTK-aware | 调大 RoPE base,等效分带 | 改配置 | 无微调替代,代码模型友好 |
| LongRoPE | 搜索每维最优非均匀缩放 | 搜索+短训 | 推到 2M+ 的商用方案 |
| 渐进继续预训练 | 4K→32K→128K 喂长文档 | 重(训练) | 质量最好,GLM/Kimi 路线 |
| 架构级(ALiBi/线性注意力/Mamba) | 换注意力机制 | 最重 | 下一代模型的事 |
| StreamingLLM/滑窗 | 只留 attention sink | 零 | 流式日志,"读过记不住" |
| RAG 外挂检索 | 不扩模型扩知识库 | 低 | 大多数场景的真答案 |
复现说明
测试环境:ThinkStation P620 · 双 RTX 2080Ti 22G · 188G DDR4 · Strata v0.1.43 · Swift-1.5-Qwen3.8-Flash-Next-IQ4_XS(GPU0 冒烟实例,与主力 IQ3_S 224K 档并存)。基准脚本 bench_speed.py(流式测 TTFT 与 decode 窗口均值),原始数据 /tmp/swift-bench-*.jsonl。YaRN 配置与 512K 档切换见 strata-iq3_s-512k.json。